
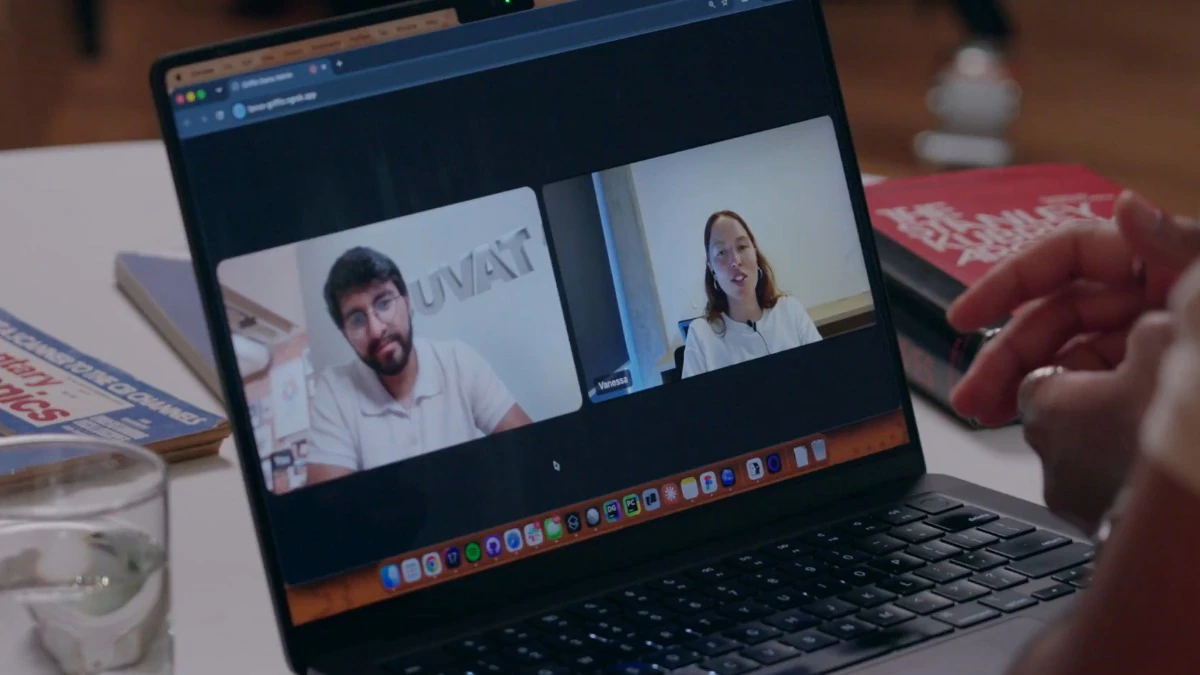
Архитектура позволяет системе видеть, слышать, интерпретировать, говорить, двигаться, реагировать и реагировать одновременно. Поскольку ее восприятие остается активным даже во время разговора, любое внезапное визуальное изменение, пауза или словесное прерывание мгновенно изменяет то, что модель говорит и делает по ходу разговора.
«Представляем Гриффина, первую модель, прошедшую видеотест Тьюринга. 48% людей, которые разговаривали с ним вживую, думали, что это настоящий человек», — написал Тавус в объявлении на X. «Предыдущие системы имели показатель прохождения теста.
Чтобы добиться плавной динамики общения лицом к лицу, Гриффин использует двухпроцессорную структуру: механизм непрерывного разговорного моделирования, который непрерывно оценивает входные данные с точностью до секунды, чтобы решить, когда вставить или использовать обратный канал с такими выражениями, как «мм-хм», и унифицированный механизм аудиовизуальной генерации, который в реальном времени визуализирует речь, движение и пиксельные настройки на уровне сцены.
Система выходит за рамки генерации изолированных движений лица. Из одного эталонного изображения Гриффин визуализирует целые динамические сцены в реальном времени, контролируя все: от естественных жестов пальцев и рук до теней и сдвигов фона.
Это также учитывает временную осведомленность, интуитивно понимая, как долго длилось молчание, чтобы определить, тратит ли пользователь время на то, чтобы собраться с мыслями, или ждет, пока модель подскажет следующий шаг.
Tavus сделал раннюю исследовательскую предварительную версию под названием Griffin-Lite, доступную избранной группе разработчиков, с планами по более широкому развертыванию полной модели в ближайшие месяцы.
